Bewerbungsdemo für die MD-IT GmbH · kein Werkzeug der MD-IT · alle Daten erfunden
Team-Assistent
Ein KI-Assistent für ein Software-Team im Gesundheitswesen. Er beantwortet Fragen zu internen Unterlagen mit Quelle und entwirft aus Tickets Testfälle und Release-Notes. Aus Antragsschreiben zieht er die wichtigsten Felder, nachdem Namen und Versichertennummern lokal ersetzt sind. Ins Ticketsystem schreibt er nur, wenn ein Mensch freigibt.
Diese Demo habe ich für meine Bewerbung als AI-Engineer (m/w/d) gebaut, mit Claude Code als Werkzeug: Python, FastAPI, ein eigener MCP-Server, lokaler Vektor-Index, Presidio, pytest und GitLab-CI. Sie spielt beim erfundenen „Team Gutachtenportal“. Alle Dokumente, Tickets und Personen sind ausgedacht.
In eineinhalb Minuten
Das Problem
Wissen steckt in Dokumenten
- Release-Prozess, Definition of Done, Teststrategie: Die Antwort steht irgendwo, aber wo? Neue im Team fragen, Erfahrene suchen.
- Ein Chatbot, der „ungefähr“ antwortet, ist schlimmer als keiner. Ohne Quelle kann niemand prüfen, ob es stimmt.
Routinearbeit und sensible Daten
- Testfälle aus Akzeptanzkriterien, Release-Notes aus einem Meilenstein: wiederkehrend und gut vorzubereiten, aber nichts davon darf ungeprüft ins Ticketsystem.
- Antragsschreiben enthalten Namen, Adressen, Geburtsdaten und Versichertennummern. Die gehören nicht zu einem Sprachmodell außer Haus.
Die Lösung
Gestrichelt: Das erledigt die KI. Durchgezogen: Das rechnet oder prüft Code. Gelb: Hier entscheidet ein Mensch.
1 · Wissensfrage
- Lokal suchenVektor- und Volltextsuche über 45 Abschnitte
- Schwelle prüfenNichts Ähnliches gefunden? Dann „steht nicht in den Unterlagen“, ohne Modell
- Antwortennur aus den Auszügen, mit Quellen-ID
- Quelle prüfenAntworten ohne gültige Quelle werden verworfen
2 · Ticket zu Testfällen
- Ticket lesenüber den eigenen MCP-Server
- EntwerfenTestfälle Gegeben/Wenn/Dann oder Release-Notes
- GegenprüfenJedes Kriterium abgedeckt? Nur echte Ticketnummern?
- Freigeben oder ablehnenbearbeiten erlaubt, Ablehnen nur mit Begründung
- Ins Ticketsystemerst jetzt, und alles steht im Protokoll
3 · Antragsschreiben
- Pseudonymisierenlokal: Namen, Adressen, Geburtsdatum, Versichertennummer
- Leck-Prüfungsteht noch etwas drin, wird nichts gesendet
- Felder herausziehenAntragsart, Leistungsbereich, Fristen, fehlende Unterlagen
- Zurückführenechte Namen nur lokal wieder einsetzen
Die drei Funktionen
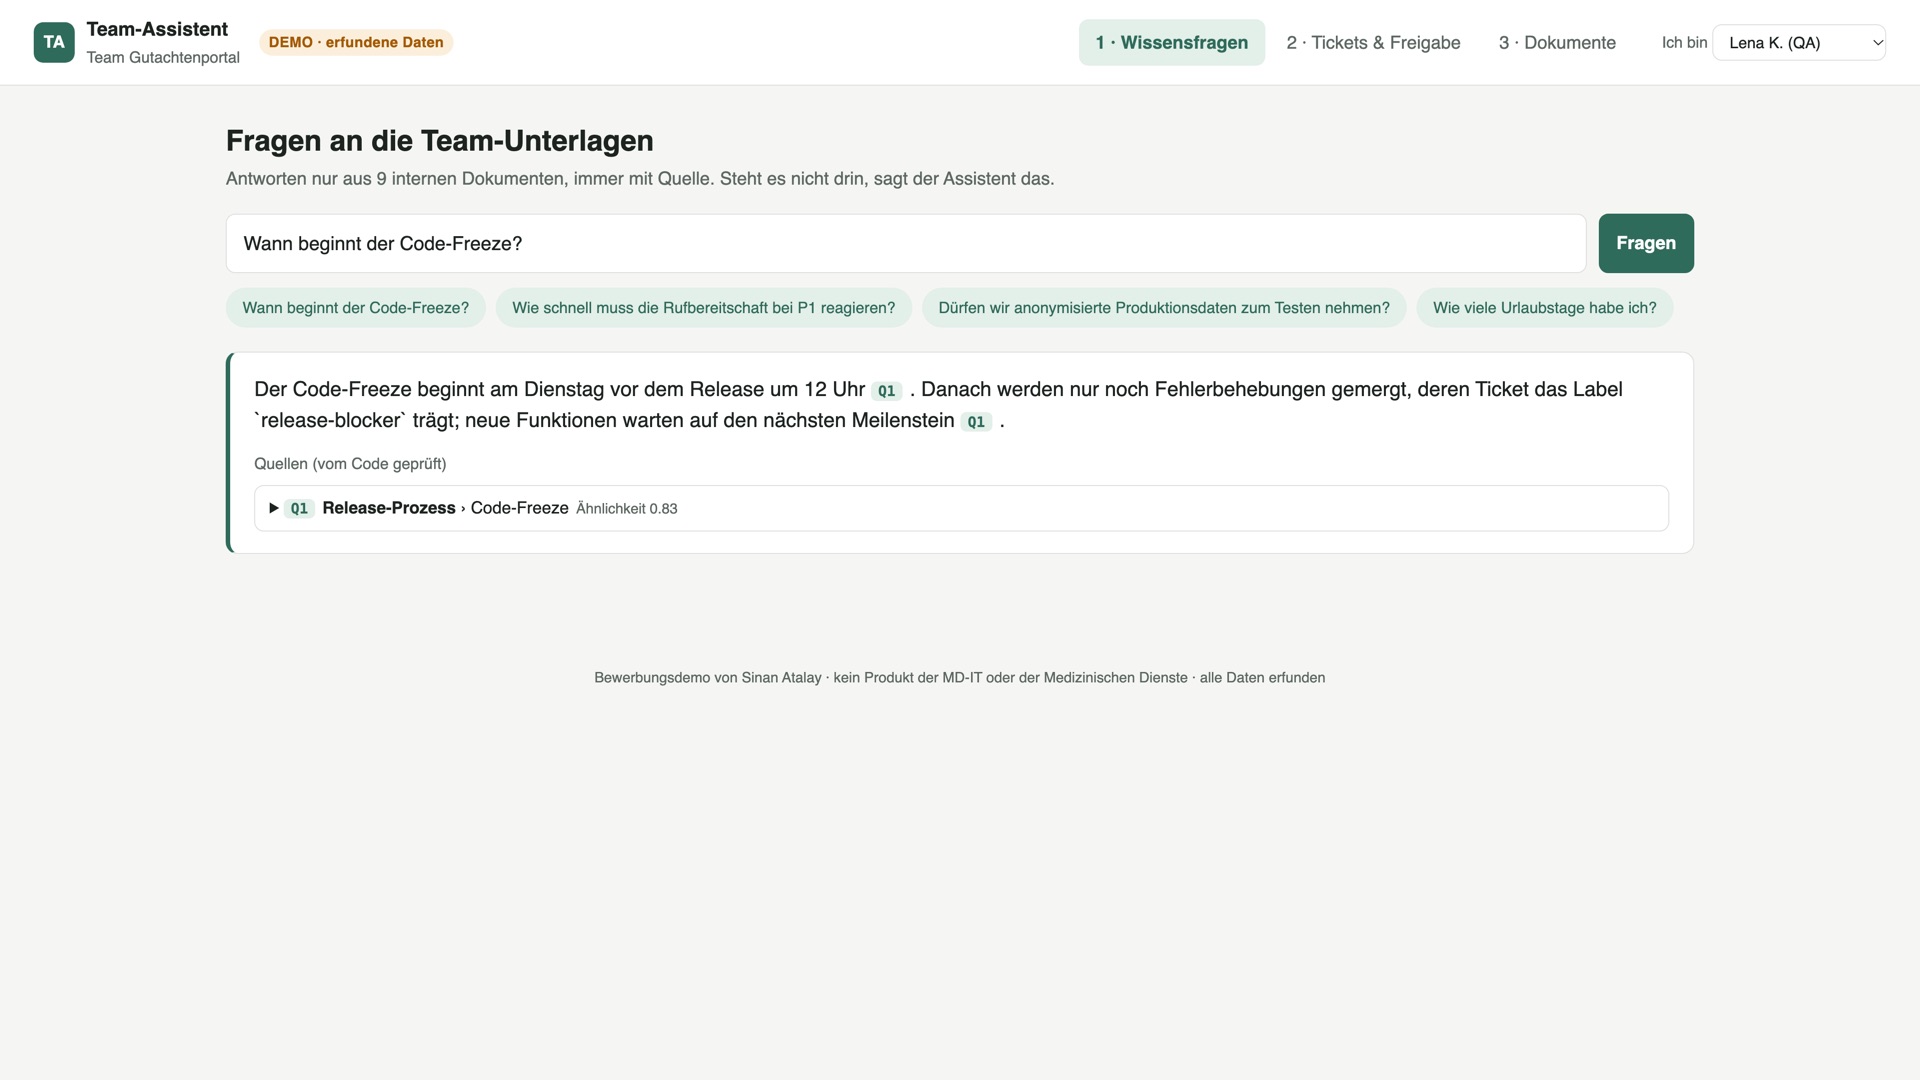
Wissensfragen mit Quellen
- 9 erfundene Team-Dokumente, zerlegt in 45 Abschnitte, lokal indexiert mit sqlite-vec und einem mehrsprachigen Embedding-Modell.
- Jede Antwort nennt Dokument und Abschnitt. Der Code prüft, dass jede genannte Quelle wirklich unter den Treffern war.
- Fragen wie „Wie viele Urlaubstage habe ich?“ beantwortet er mit „Das steht nicht in den Unterlagen.“
- Ein Eval-Satz mit 15 Fragen misst die Trefferquote: Mit Claude sind alle 15 richtig belegt oder richtig abgelehnt. Die Suche allein läuft auch in der CI.
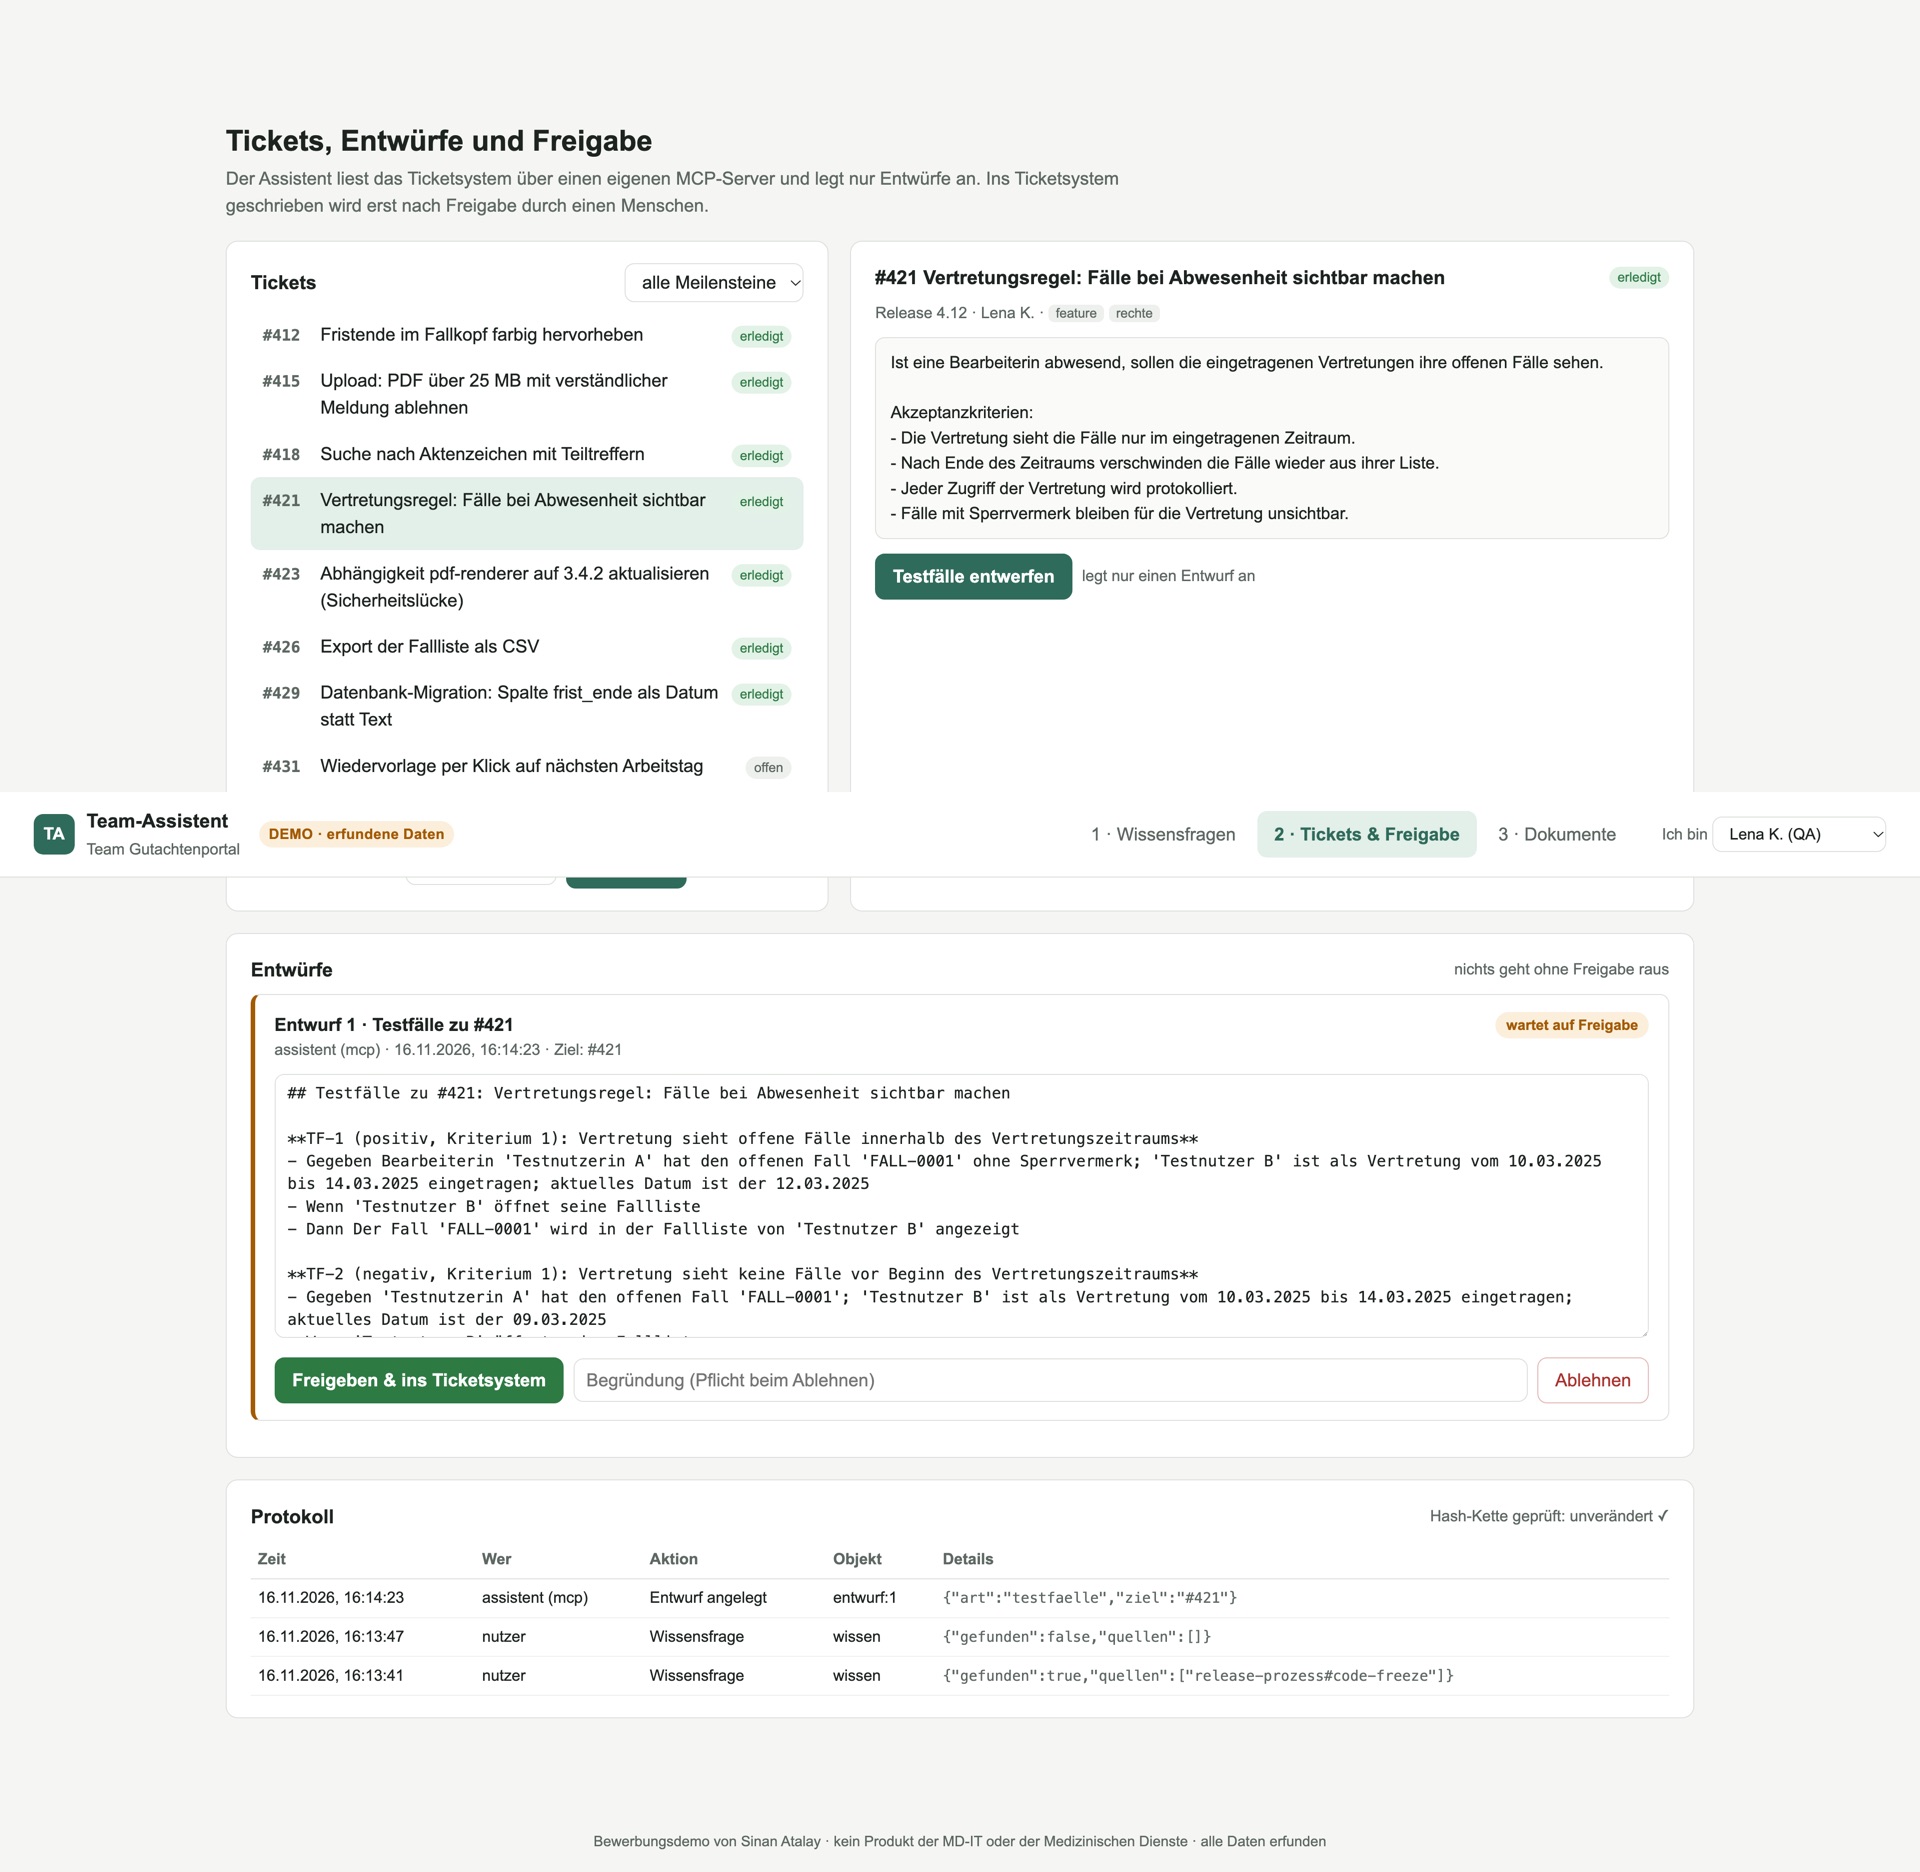
MCP-Server am Ticketsystem, mit Freigabe
- Eigener MCP-Server mit dem offiziellen Python-SDK und drei Werkzeugen:
tickets_suchenundticket_lesennur lesend,entwurf_anlegennur für Entwürfe. - Dahinter ein nachgebautes GitLab mit 15 erfundenen Issues und der echten REST-Schnittstelle. Für ein echtes GitLab reichen URL und Token.
- Aus einem Ticket werden Testfälle, aus einem Meilenstein Release-Notes. Der Code prüft, ob jedes Akzeptanzkriterium abgedeckt ist und ob nur echte Tickets vorkommen.
- Ins Ticketsystem geschrieben wird erst nach Klick auf „Freigeben“. Jede Aktion steht im Protokoll, als Hash-Kette gegen nachträgliche Änderung gesichert.
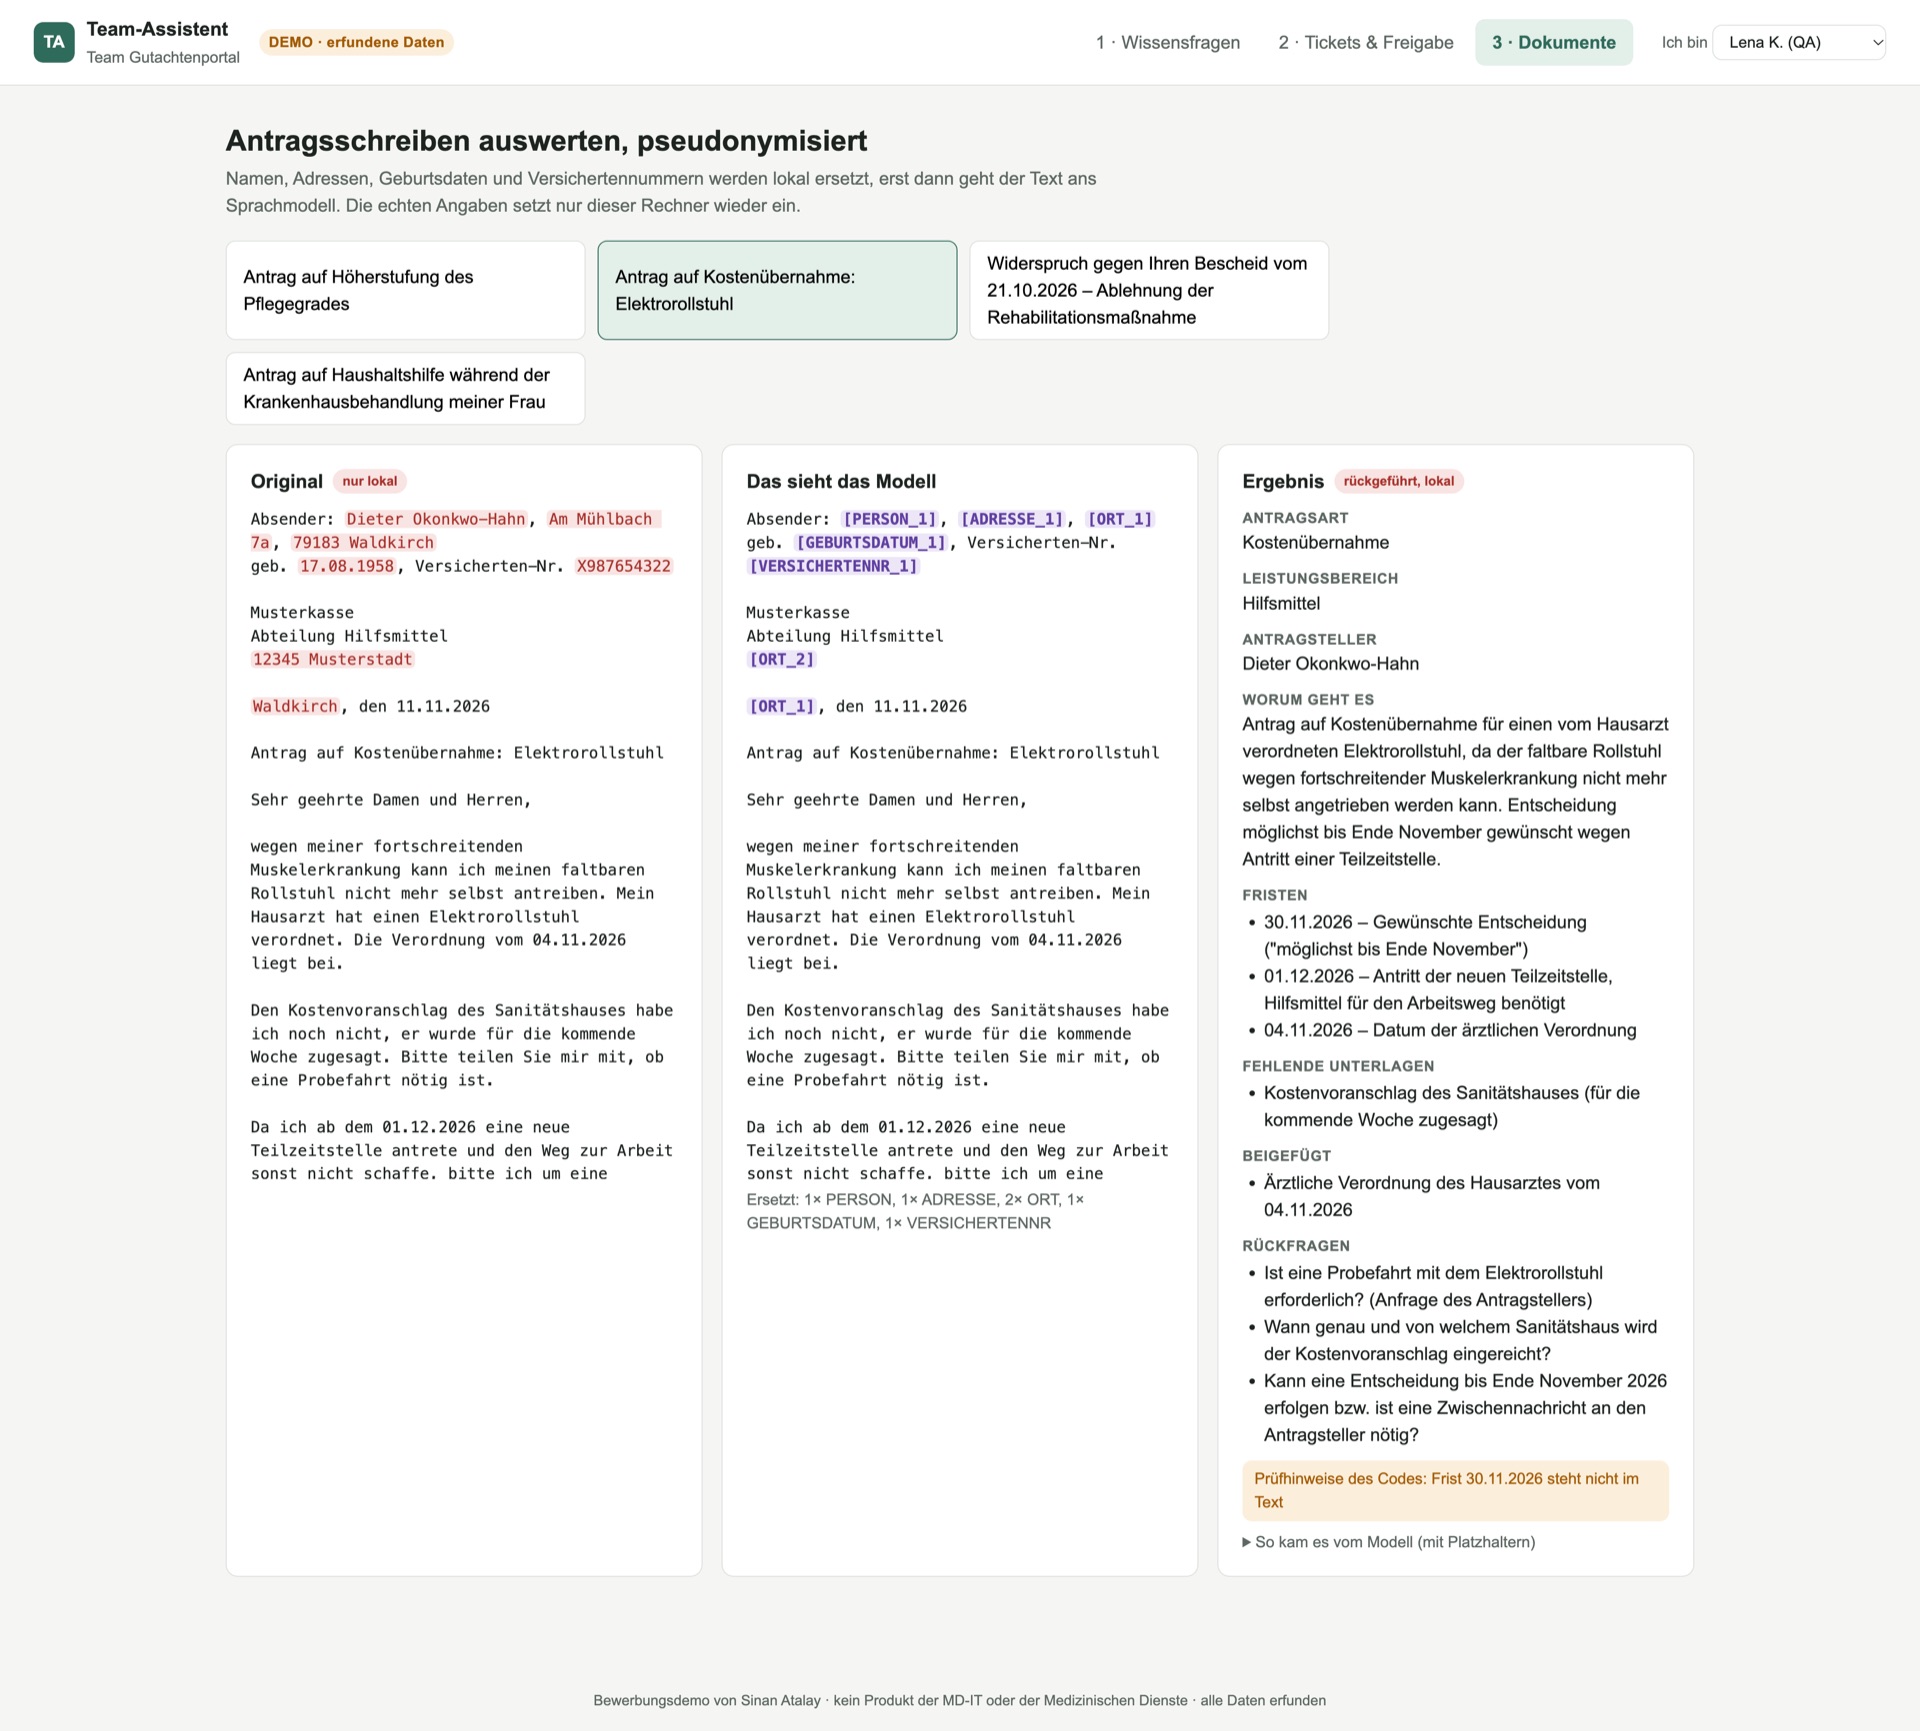
Dokumente mit Pseudonymisierung
- Vier erfundene Antragsschreiben: Pflegegrad, Hilfsmittel, Widerspruch, Haushaltshilfe.
- Lokal ersetzt: Namen (Presidio mit spaCy), Versichertennummer, Geburtsdatum, Adresse, Telefon (feste Regeln). Auch der Ortsname in der Datumszeile und der einzeln stehende Nachname.
- Das Modell bekommt nur Platzhalter wie [PERSON_1] und liefert JSON mit Antragsart, Leistungsbereich, Fristen und fehlenden Unterlagen.
- Nebeneinander sichtbar: Original (nur lokal), was das Modell gesehen hat, Ergebnis.
Architektur
- 52automatische Tests, alle grün
- 15 von 15Eval-Fragen mit Claude richtig belegt oder richtig mit „steht nicht drin“ beantwortet
- 0Schreibzugriffe ohne Freigabe
- 4 von 4Schreiben ohne Namen oder Versichertennummer beim Modell
Datenschutz-Konzept
So schützt die Demo Daten
- Datenminimierung vor dem Modell: Personenbezogene Angaben werden lokal ersetzt, bevor ein Text den Rechner verlässt.
- Leck-Prüfung als Sperre: Steht danach noch eine Versichertennummer, ein Geburtsdatum oder ein Originalname im Text, wird nichts gesendet.
- Die Zuordnung bleibt lokal: Welche Platzhalter zu welchem Namen gehören, liegt nur im Arbeitsspeicher. Es wird weder gespeichert noch protokolliert.
- Suche ohne Cloud: Das Embedding-Modell läuft lokal.
- Mensch in der Schleife: Wirkung nach außen erst nach Freigabe, mit Name und Zeit im Protokoll.
Was im echten Betrieb dazukäme
- Pseudonymisierung ist nicht Anonymisierung: Seltene Diagnosen oder Lebensumstände können Rückschlüsse zulassen. Dazu gehört eine Datenschutz-Folgenabschätzung.
- Die Erkennung ist auf die Formate der Demo abgestimmt. Im Betrieb würde ich die Erkennungsquote an einem größeren synthetischen Testsatz messen.
- Ein Modell mit EU-Datenhaltung oder im eigenen Rechenzentrum, angebunden über die vorhandene Provider-Schicht.
- Echte Anmeldung mit Rollen statt Namenswahl per Klick, Vier-Augen-Prinzip für Release-Notes.
Was ich gebaut habe und womit
Technik
- Backend: Python, FastAPI, eine kleine Provider-Schicht für Claude (Anthropic-API) und Azure OpenAI, strukturierte Ausgaben nach JSON-Schema
- RAG: sqlite-vec, SQLite-Volltext, mehrsprachiges Embedding-Modell über ONNX, Reciprocal Rank Fusion
- MCP: eigener Server mit dem offiziellen mcp-SDK, vom Backend als Client genutzt, auch in Claude Desktop einsetzbar
- Datenschutz: Microsoft Presidio, spaCy (de_core_news_md), eigene Erkennungsregeln
- Qualität: 52 pytest-Tests, ein Eval-Satz mit Trefferquote, ruff, Dockerfile, docker-compose, .gitlab-ci.yml mit Lint, Tests, Eval und Container-Build
Ehrlich gesagt
- Gebaut habe ich die Demo selbst, mit Claude Code als Werkzeug, an einem Tag. Architektur, Regeln und Prüfungen habe ich festgelegt, und ich habe jede Stelle getestet.
- Ich habe keinen IT-Abschluss. Deshalb zeigt die Demo vor allem, wie ich arbeite: mit Tests, Messung, Dokumentation und klaren Grenzen für die KI.
- Alle Daten sind erfunden: Team, Dokumente, Tickets, Personen und Schreiben. Mit echten Inhalten der Medizinischen Dienste hat die Demo nichts zu tun.
- Bewusst vereinfacht: GitLab ist nachgebaut, Docker ist lokal nicht gebaut (das übernimmt die CI), Azure OpenAI ist vorbereitet, aber nicht live angebunden.
Live ansehen?
Im Gespräch zeige ich Ihnen den Team-Assistenten gern live und erkläre den Code, die Tests und die Grenzen.